当前位置:首页 > 大白菜资讯 > ChatTTS要在本地跑吗?Windows本地部署语音合成的方法
ChatTTS要在本地跑吗?Windows本地部署语音合成的方法
试过在网页上合成语音,导出来的音频总带着平台的尾巴。想在自己电脑上跑,又卡在装依赖那步,满屏红字看不懂。
一、先把 Python 和 Git 准备好
ChatTTS 需要 Python 3.9 到 3.11。装 3.12 及以上版本时,部分依赖还没有预编译包,pip 会尝试本地编译然后失败,这是新手最常见的卡点。
到 python.org 下载 3.10 或 3.11 的 Windows 安装包,安装时务必勾上「Add python.exe to PATH」。装完打开 PowerShell,执行 python --version 和 pip --version,两条都能返回版本号才算成功。
Git 从 git-scm.com 下载安装,一路默认即可。装完执行 git --version 验证。有 NVIDIA 显卡的,去官网装最新的显卡驱动,ChatTTS 会自动检测并使用 CUDA,没有独立显卡也能用 CPU 跑,只是慢。
二、建虚拟环境,别装进系统 Python
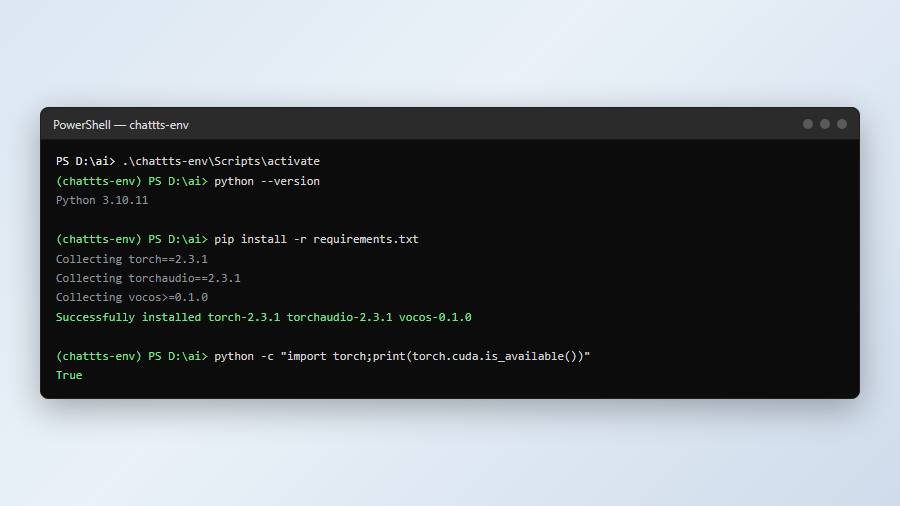
所有依赖都装在虚拟环境里,出问题直接删目录重来,不会污染系统。选一个空间足够的盘,比如 D:\ai,在里面开终端:
python -m venv chattts-envchattts-env\Scripts\activate
激活成功后命令行前面会多出 (chattts-env)。如果提示「无法加载文件,因为在此系统上禁止运行脚本」,先在 PowerShell 里执行 Set-ExecutionPolicy -Scope CurrentUser RemoteSigned,输入 Y 确认,再激活一次。
顺手把 pip 源换成国内镜像,装依赖会快很多:执行 pip config set global.index-url,后面接镜像地址(清华源的主机名是 pypi.tuna.tsinghua.edu.cn,路径加 /simple)。这一步不是必须,但能省下大量等待时间。
三、拉代码、装依赖,重点看三个包
在同一个终端里执行:
git clone 加上 ChatTTS 的仓库地址(2noise 维护的那个仓库)cd ChatTTSpip install -r requirements.txt
依赖里最关键的是 torch、torchaudio 和 vocos。有 N 卡的话,装 CUDA 版 torch 才能用上显卡加速:pip install torch torchaudio --index-url 后面接 PyTorch 官方给出的 cu121 索引地址。装完执行 python -c "import torch;print(torch.cuda.is_available())",返回 True 说明显卡可用。
装依赖过程中如果卡在 Building wheel for ... 很久最后报错,多半是缺 C++ 编译环境。装一个「Microsoft C++ Build Tools」,勾选「使用 C++ 的桌面开发」再重试,或者干脆把 Python 换成 3.10 重新建环境。
首次运行会自动下载模型文件,体积约 1GB 出头,落在用户目录的缓存里。国内网络下载慢的话,可以先手动下载模型放到 %USERPROFILE%\.cache\huggingface\hub 对应目录下,再启动。
四、启动 WebUI,跑出第一段语音
官方仓库自带一个 Gradio 界面,最省事。在项目目录执行:
python examples/web/webui.py
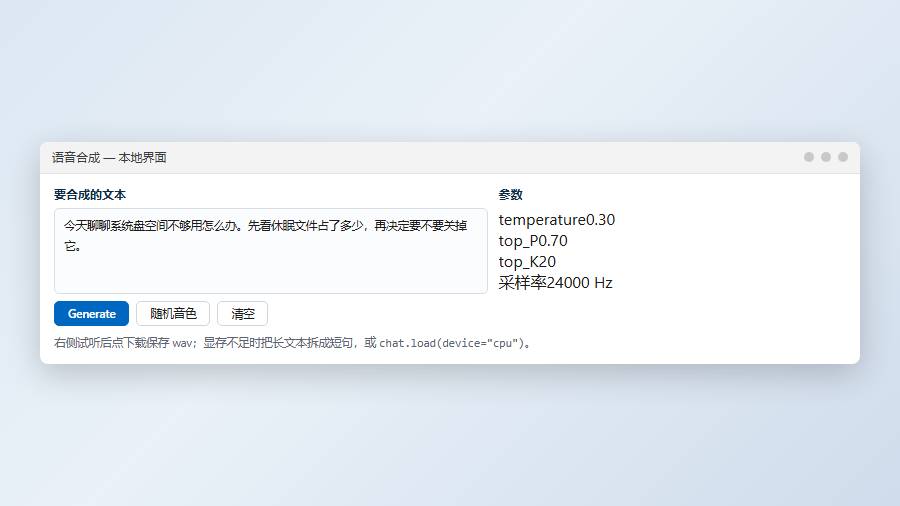
首次启动要下载界面依赖并加载模型,等一两分钟,终端会打印一个 127.0.0.1:8080 这样的本机地址,浏览器打开就能用。文本框里输入要合成的内容,点 Generate 生成,右侧试听后点下载保存 wav。
显存不够时会报 CUDA out of memory。处理办法有三个:把长文本拆成短句分批合成;在代码里指定 chat.load(compile=False) 关掉编译优化;或者直接强制用 CPU:chat.load(device="cpu"),速度慢但不会爆显存。8GB 显存跑默认参数基本够用,4GB 建议用 CPU。
想要稳定音色,用 chat.sample_random_speaker() 生成一个 speaker 向量并保存下来,下次加载同一个向量,音色就固定了。不固定的话每次合成都是随机的,做系列音频会前后不一致。
五、批量合成与参数调优
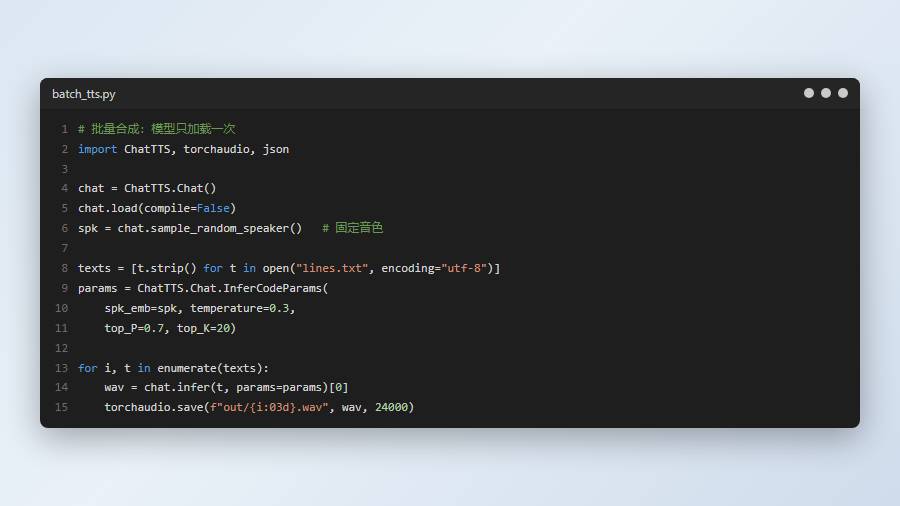
做几十上百条音频时别用界面点,写个脚本循环调用。核心参数有三个:temperature 控制随机性,0.2 到 0.4 比较稳;top_P 取 0.7 左右;top_K 取 20。参数调太高会出现读音飘、语气怪的问题。
文本里可以插入 [uv_break] 表示停顿、[laugh] 表示笑声,用来控制节奏。中文长句建议按句号切开,每段不超过 40 字,合成后再用 ffmpeg 拼起来,音质和连贯性都更稳。
批量导出时用 torchaudio.save 直接写文件,采样率固定 24000,格式用 wav 无损,需要 mp3 再用 ffmpeg 转:ffmpeg -i in.wav -b:a 128k out.mp3。别在循环里反复 load 模型,模型加载一次放在循环外面,速度差好几倍。
六、常见问题
启动报 ModuleNotFoundError?确认终端前面有 (chattts-env),说明虚拟环境没激活,依赖装到别处去了。重新激活后重装一次。
生成的声音像机器人、断句奇怪?把 temperature 降到 0.3,文本按标点切短,别一次塞几百字。音色向量也要固定,随机音色本身就容易出怪声。
能不能商用?开源协议是 AGPL,商用前先读仓库里的 LICENSE,涉及对外提供服务时 obligations 比较重,别拿去做付费产品。
先把 Python 版本降到 3.10,能省掉一大半装依赖的坑。跑通之后再折腾参数,一上来就调音色只会越调越乱。